Нейросети: популярность, железо и сжатие.
Нейросети: популярность, железо и сжатие.
Недавно попались пару заметок о доступности и популярности нейросетей для пользователей! Решил поделиться сутью, но со своей колокольни!).
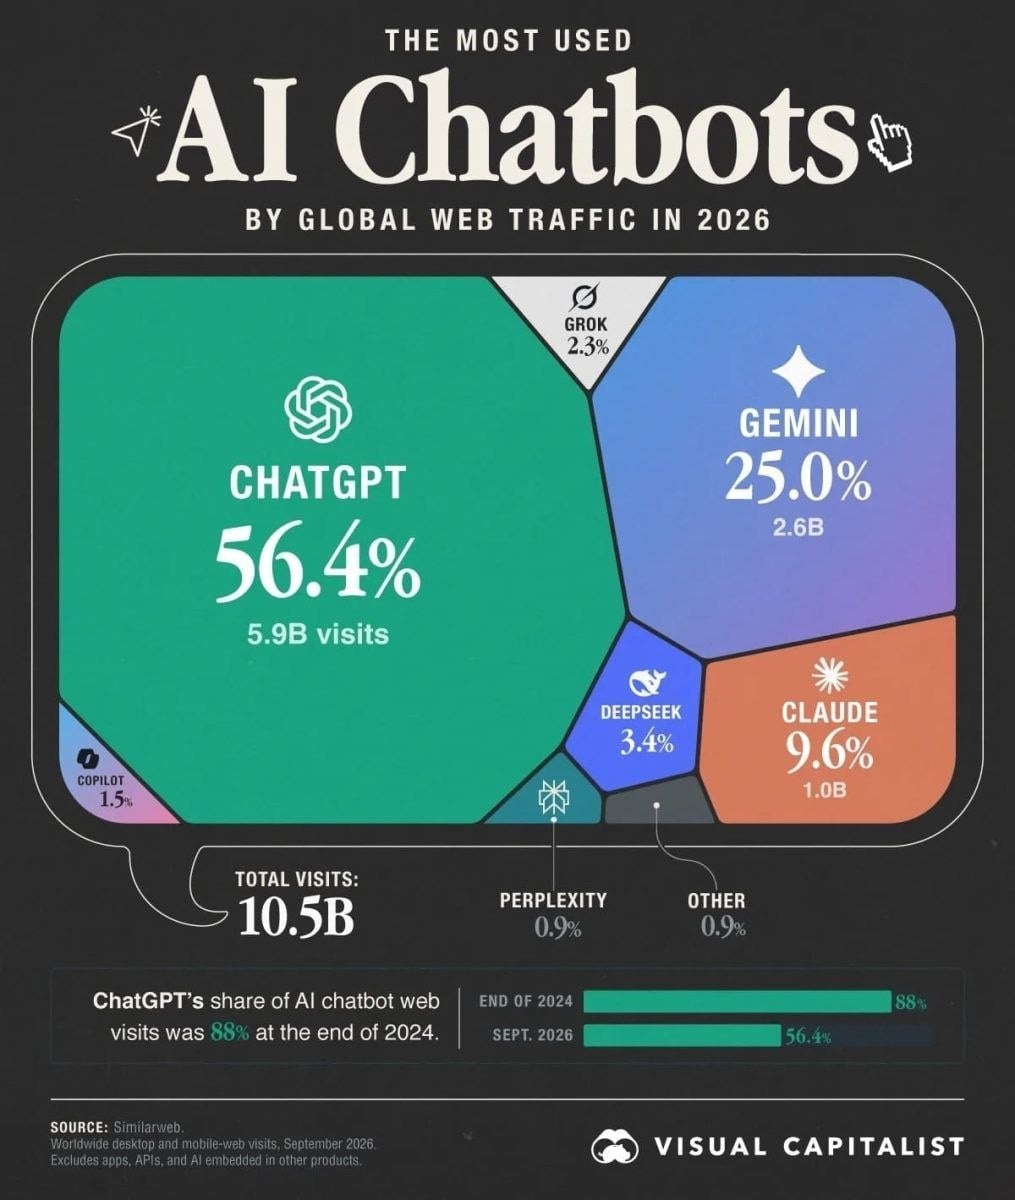
Начнем с популярности. Что же мы видим в первую очередь на рынке успехов разных ИИ-компаний на этом первом графике?!
Сразу в глаза бросается доминирование Chatgpt с чуть более чем половиной рынка. Однако в долгую ее качественные показатели падают: доля Чата сократилась за 2 года на треть, на 32 процента. Что это, результат платной политики, дорогих подписок, и закрытых весов, или развитие конкурентов, до конца не ясно?! Наверное, весь комплекс факторов. Ведь наряду с дорогими в подписках сетями, вроде Astra 6.0, есть и гораздо более доступные и эффективные Sol 6.1 и Luna 5.6!


Также наблюдаем стабильность, точнее стабильный рост Gemini от Гугл! За счёт удачного поисковика прежде всего, "откусившей" почти всю потерянную долю Chatgpt в четверть рынка! Неплоха и бесплатная доступная ее версия Gemma на 22 B параметров. Видим также и рост Cloud до заметных величин, за счет математической и логической точности, развития профессиональных навыков в коде, математике, экономике, анализе за теже или меньшие деньги, нежели Open AI! Как раз оставшаяся доля заметного роста перешла к ним).

Ну и видим не вполне ожиданно скромные показатели Deepseek, несмотря на большой китайский рынок, популярность в России, пиар и сильные бесплатные характеристики! Они едва заняли стартовые места и доли той же Гемини или Клод на старте ИИ-бума 2-3 летней давности, с 3,5 процентами доли рынка! Это, наверное, не так и плохо с нуля и для подписок (ведь многие их ещё и локально гоняют!). Но ожидалось больше.
Grok тоже, после падения волны хайпа в мире и закрытия в России, мире открытых весов, просел в популярности, кажется с 2,5 процентами своими! Copilot от Майкрософт также не слишком развит, и узкоспециален. Но полтора процента не так плохо для старта. А вот то, что нет Qwen - странно, сильные и популярные бесплатные модели для всех типов задач. Особенно хороши в кодинге, математике, и точных научных задачах, при относительно небольших размерах весов.(Зато локально их используют почти все!).


Ну и неудивительно, наверное, несмотря на весь громкий хайп и рекламу, итп, итоговый пшик наших Алис и Гигачатов в плане популярности! Даже новые и большие модели с МоЕ, мультимодальностью, и неплохими данными в тестах никому не нужны! Что это, отсутствие рекламы, закрытость кода, или политическая повестка?! Но факт вещь упрямая: "и с дЯньгами нянать и даром нянать", как говорится! Остаётся довольствоваться разве что утешительным литературным призом: написанием, точнее восстановлением второго тома "Мёртвых душ"). Ну для крепостного податного населения России - очень актуально, по мысли Сбер-банкиров, видимо! :).

Но нейросети вначале нужно же на чем-то развернуть. И не все и не всем можно доверить облаку и подписке! Кому-то нужно защищать корпоративные интересы и разработку, кому-то авторскую мысль и собственность, кому-то спасаться от рекламы, кому-то даже просто поберечь деньги на подписки! Потому даже в любительском сегменте пользователей, программистов, вайб-кодеров, блогеров, писателей, художников, бизнесменов, итп растет мода на локальные станции, локальных агентов на своём железе. У себя дома без цензуры, без слежек, корпораций, рекламных компаний, и государства (ну почти!). С обучением на своем материале, под свои привычки, хотелки, и темп работы, хобби, умный дом, итд.


И вот тут вырисовываются два раза фундаментально разных подхода и стратегии к домашнему/локальному инференсу или обучению сетей: "старообрядческий" и громоздкий путь с большой и мощной картой, или группой карт (в связке, серверной стойке, итд!). Или новый и удобный, экономичной для розетки, и компактный путь с Мини-ПК или ноутбуком на чипе, где быстрая и большая память распаяна сразу на кристалле и для процессора и для видеочипа сразу, давая в инференсе скорость почти на уровне топовых видеокарт, только в намного большем объеме и дешевле (64-128 ГБ видеопамяти на кристалле обойдётся вам по цене 32-48 ГБ ВРАМ на картах-в 200-300 тысяч! И даст вам доступ не только к малым и средним, но и большим умеренно квантованным сетям!).
Особенно в этой области прославились недавние чипы Мак, Макс и Студио. Ну и у АМД на Стрикс Хало и Стрикс Пойнт есть успехи. Свои наработки сделала и Нвидеа в новом чипе Спаркс со специально созданной под него сетью Немотрон 3-3,5 (со 122 B параметров разными МоЕ экспертами, толи на 12-16, толи на 22 B параметров каждый. В общем, с возможностью размещения в видеокарте на 16-24 ГБ! А также и ее облегченную Флэш-версию Болт, на 72 B, тоже с МоЕ).


Но Спаркс очень дорогой (там от полумиллиона начинается база!), Стрикс Хало или Мак самый дешевый и не всегда и во всем эффективен! И если у вас уже есть есть ПК, и все же вы решите на своём игровом или рабочем ПК развернуть пару сеток чисто для чатика, тестов и блогинга, научной работы или серьезного обучения и программирования, то вот вам несколько концептов по сжатию больших плотных сетей для на видеокартах прежде всего!
Хотя эти данные остаются релевантными и для Мини-ПК и для ноутбучных чипов). Физика и математика больших языковых моделей примерно одинакова для любого железа и зависит больше от софта и экосистемы: Интел, АМД, или Нвидеа). Может быть Мак ещё или новые пока начальные китайские конкуренты, как аналоги!


Как видно из этой графики даже относительно небольшая, средняя и универсальная умная Qwen, та самая на 27 B параметров, весит больше ГБ, чем у неё млрд. параметров. Примерно, вдвое: 55 ГБ против 27 Б! Но квантование, даже в очень комфортном и легком кванте Q8-Q6 сохранением всех практически мощностей, сжимает её вдвое и более, до 22-28 ГБ. Делая доступной локально на больших и редких потребительских видеркартах на 24-32 ГБ с высокой скоростью инференса (40-50 токенов в секунду!). Да, размеров под контекст будет немного (2-3 ГБ на 64-128 тыщ. токенов), если не квантовать дальше, но работать будет быстро и комфортно!
В карту чуть меньшего масштаба до 16-20 ГБ получается можно терпимо "засунуть" более жесткие кванты Qwena без больших потерь типа Q-4. Для контекста окно тоже не будет слишком большим 4-5 ГБ, но для 128 тысяч токенов (размер большой книги или приличная средняя программа) этого вполне должно хватить!

Конечно, средние и умные сети можно и дальше сжимать до Q-3 или Q-2, чтобы даже в средних потребительских картах на 8-12 ГБ они пошли хотя бы "черепашьим шагом"! Однако такой путь ведет обычно к потерям, ошибкам и заметному "поглупению" модели!).
Чуть более разумным путем представляется на картах 10-12 или 16 ГБ, потребительских, использование малых и точных сильных плотных моделей на 7-14 миллиардов параметров, вроде той же малой Qwen. В умеренном кванте Q-4, Q-6 они будут весить там примерно 8-12 Гб и полностью помещаться на видеопамять! При этом в работе с кодом, инструкциями, точным анализом, итп, все ещё очень хороши. Особенно, разные спецификации Qwen-14 Б. Да там не очень много места будет под контекст, порой не больше 1 ГБ на 32-64 тысячи токенов, но работать можно!). К тому же МоЕ сети совсем большие 70 или 135 Б - Liama или Дипсик или наш Немотрон Нвидеа также могут полностью поместиться в мини карте на 12-16 ГБ, используя гораздо большие вычислительные мощности больших сетей для меньшего узкого и точного круга задач!


Кроме того, можно даже на картах 12-16 ГБ запустить и сети побольше 7— 14 Б, вроде Мистраль 7×7 B, или или даже 27 Б Квен эту, имея достоточно мощный процессор и много быстрой оперативной памяти ДДР-5, которые "дожуют" половину сети этой не на видкопамяти, а за свой счёт! Да, там скорость снизится, примерно, до 3-5 токенов в секунду. Скорость нашего чтения, но работать будет.
Таким же путём можно на картах 24-32 ГБ от Интел, Радеон и НВидеа запустить неспеша и уже большие открытые сети, вроде Liama или Дипсик 70 B+, или французскую Микстраль 49 Б, 7×7! Да, там скорость будет маленькой (даже в жестком кванте они весят 35-50 ГБ), но ошибку памяти не выдаст. А уж две потребильских карты на 20-24 ГБ в связке через НВЛинк, или софтверный Тензор Параллелизм Интела или Нвидеа, или АМД дадут вам (с 40-48 ГБ или даже 64 ГБ видеопамяти) огромную скорость в работе и плотными Лиама или сетями на 100 Б+ (да, в серьёзном квате Q-4, чтобы влезть 40-60 ГБ, и оставить место под контекст!). Или с настоящими гигантами с МоЕ, вроде Дипсик 120, 135 B).


Однако в этой же категории спаренных карт для "плотных" ИИ- монстров с 70-105 миллиардами параметров и больше, мы снова возвращаемся к нашим покинутым Мини-ПК! Имея память 96-128 ГБ (или тем более, 192 ГБ!) можно позволить себе локально запускать на ПК не только умных середняков Квин и Микстраль, но настоящих монстров 70, 100 или даже 135-200 Б в умеренном кванте и без особой потери качества!
Таже самая практически вычислительная мощь Гемини или Дипсик мощных, но дома. Да, скорость рассчетов или инференса упадет, относительно двух карт иногда очень серьёзно, или там средних моделей: Мак Студио и Макс показывает в больших моделях 70-105 в кванте - 10-12 токенов/сек., Спаркс Нвидеа неадаптированный ещё около 5,5-6 токенов, Стрикс Хало АМД с 96-128 ГБ всего 3,5-4 токена. Но большие сети именно что работают на них. (На стационарном ПК, даже с самой мощной картой на 24-32 ГБ они либо не пойдут, кроме некоторых МоЕ, либо будут 1-2 токена нечитаемых выдавать на процессоре! Так как видеопамяти не хватит, а проц после быстрых рассчетов картой будет буквально ползти!). И даже 2 больших карты в больших сетях будут нередко слабее Мини-ПК или ноута на мощном чипе с распаянной быстрой памятью ЛДДР-5! (Хотя все ещё заметно быстрее в мало-средних сетях).


Однако делать серверную стойку на 2-4 карты дома просто так, покупать дорогой и горячий серверный проц и прочее - это не только горячий и шумный конфиг дома, огромные цены на электричество и сами чипы, и память б/у, но ещё и сомнителное преимущество перед Мини-ПК вообще. Ведь теже Маки идеально собираются из нескольких маленьких коробочек в одну большую 10 Г/сеть. И выдают скорость не меньшей серверной стойки! Потребляя как пару карт всего).
В любом случае, друзья, какой бы выбор вы не сделали в пользу ноутбука с хорошей и процем, или стационара с парой карт (или адаптируете одну свою!), или все же возьмете мощный и современный экономичный Мини-ПК. Или вообще разумно и экономно предпочтете сервер, облако и подписку, в придачу к своему старому базовому компу небольшому! Какую бы модель или их семейство вы бы не выбрали и для какого нужного вам круга задач, но, очевидно, что без нейросетей, и нормальной базовой рабочей станции сегодня никуда! Даже если вы настоящий эксперт и мастер своего дела в своей области - программист, финансист, ученый, писатель, блогер, то это несказанно ускорит и облегчит ваш труд, и сделает его более интересным! Почему автор и решил написать этот поверхностный, пространный, но абсолютно искренний и человеческий опус! От первого до последнего знака).

А какими нейросетями, для каких задач и на каком железе пользуетесь, вы друзья?! Какие у вас любимые и эффективные, на ваш взгляд?!
Версия этого поста в моём Телеграм канале втором, по ссылке. Где я не только о футболе или кино, но и экономике, жизни, истории, технологиях, итд, пишу. В связи с блокировками Телеграм, все это под вопросом, но зайти посмотреть все ещё можно! Ведь Телетайп тоже на грани блокировки и закрытия и свой сайт на Ворд Пресс, Тильде или западные платформы скоро останется единственной возможностью честного и независимого блогинга в России):
https://t.me/marginalisfiction2025/862