ОТКАТ ИЗМЕНЕНИЙ
Как-то так получилось, что “откат изменений” звучит часто, но редко говорят, как он вообще происходит с точки зрения рабочего процесса. Хотя откат — является такой же полноценной частью workflow и тоже в целом попадает в понимание git’a
Первое правило надёжного релиза — уметь быстро вернуть систему в рабочее состояние. Отказоустойчивый процесс отката строится на трёх уровнях:
- управление историей Git,
- управление артефактами и окружениями,
- управление конфигурациями и инфраструктурой.
Разные приёмы — от git revert до blue/green-деплоймента и feature-флагов — сокращают MTTR (англ. Mean Time To Recovery — среднее время восстановления работоспособности сервиса после сбоя или инцидента) и сводят риски к минимуму.
Какие есть стратегии отката?
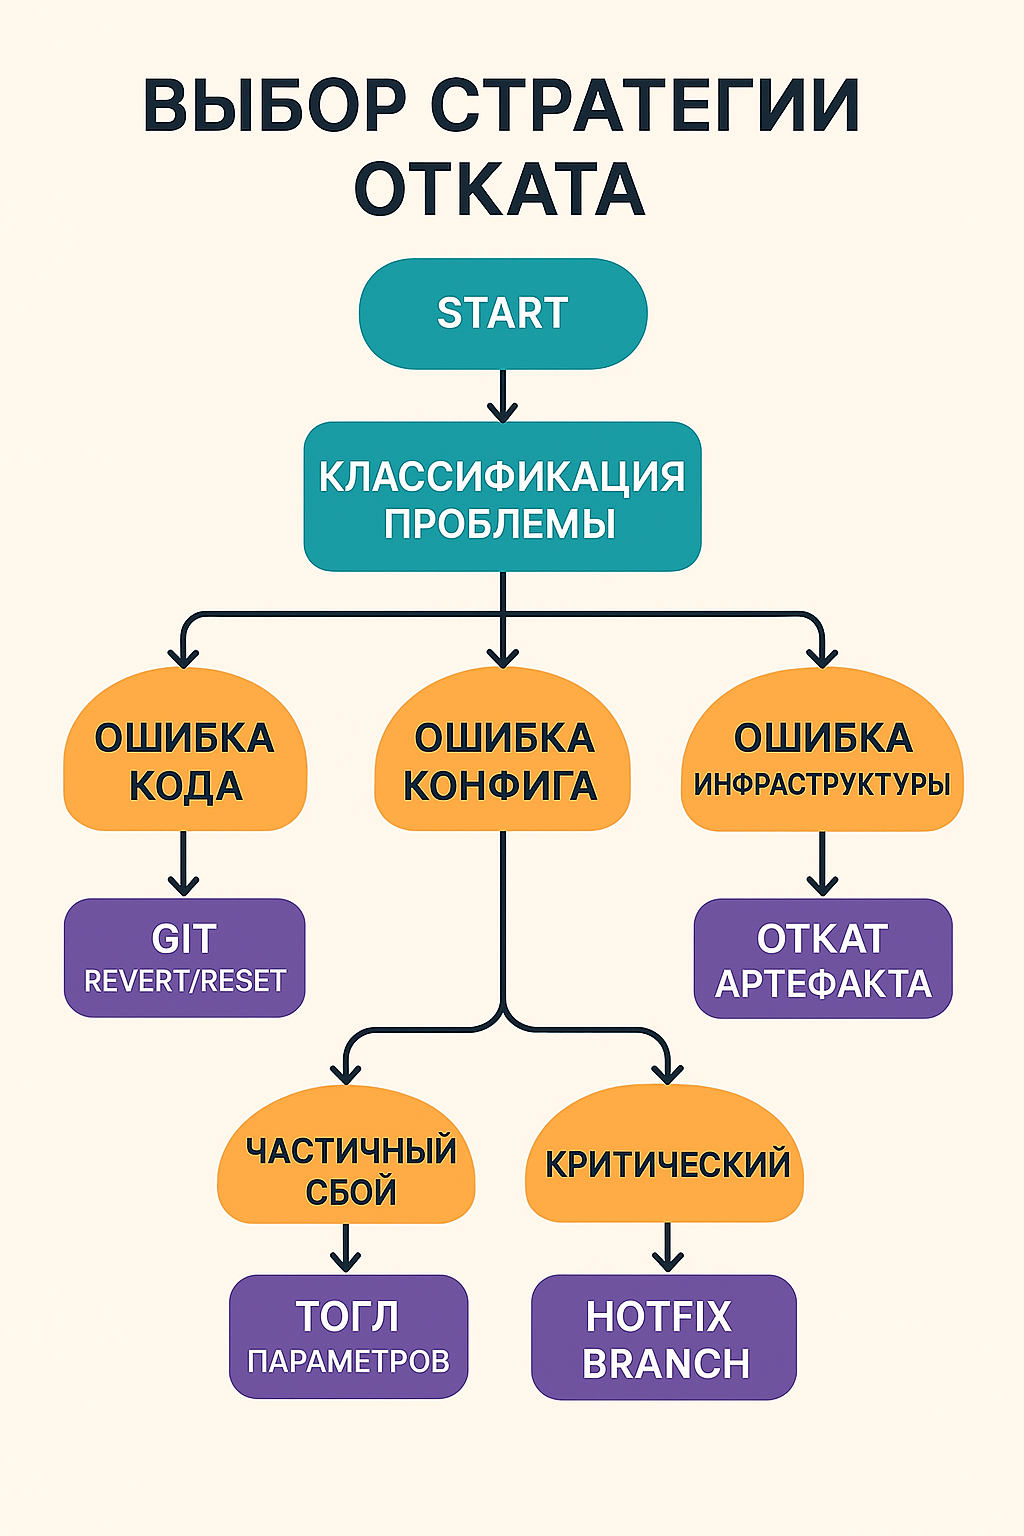
- Ошибка кода → Git revert/reset.
- Сбой инфраструктуры → Откат артефакта.
- Ошибка конфигурации делится на два сценария:
Когда в общем-то нужен откат?
1. Баг после мёржа в master
После merge новой ветки в master появляется какой-то баг, который ранее уже был исправлен или вообще не встречался. Короче, старое поведение сломалось из-за нового изменения.
Пример: добавили новую фичу, и с ней случайно вернули баг, который раньше уже исправили. В результате что-то, что работало, после релиза снова не работает.
2. Несовместимый конфиг, упавший pod или ошибочный Helm-чарт
- Несовместимый конфиг — с ошибками или нерелевантными параметрами, из-за чего сервис не может корректно стартовать.
- Упавший pod — в Kubernetes
podне стартует или сразу падает из-за вышеуказанных ошибок в конфиге или обновлении. - Ошибочный Helm-чарт — при деплое через Helm передан неправильный шаблон или параметры, сервис не запускается или работает неправильно.
Пример: задеплоили сервис с новым конфигом, в котором неправильно указан адрес базы данных. В результате pod не стартует, или сразу завершается с ошибкой, или работает некорректно — все варианты имеют место быть. Всё зависит от деплоймента.
3. Неуспешная миграция БД
При миграции БД меняется структура базы данных (добавление столбцов, изменение типов данных и т.д.). Неуспешная миграция — изменения к базе применились некорректно, с ошибками или частично.
Пример: скрипт миграции выполнился не полностью: часть данных потеряна или структура теперь несовместима с приложением — сервис начинает падать или работать с ошибками.
4. Частичная деградация функциональности, устранимая флагом
Частичная деградация — это когда не весь сервис перестал работать, а только какая-то функция, но главная работа продолжается. Если предусмотрены feature flags (флаги фич), проблемную функцию можно временно отключить, не откатывая весь код.
Пример: вышло обновление, и сбоит только недавно добавленный виджет: можно временно его выключить с помощью конфигурационного флага, а не возвращать всю систему назад.
Итог:
Все эти ситуации — типичные сценарии, когда требуется быстрое реагирование и откаты.
ТЕПЕРЬ ПРО САМИ СТРАТЕГИИ
Откат в Git
1. git revert — безопасный откат
Создаёт новый коммит, инверсно повторяющий изменения, сохраняя публичную историю и не ломая чужие репозитории.
2. git reset --hard — машина времени
Перемещает указатель ветки и рабочее дерево на указанный SHA (хеш коммита), безвозвратно теряя коммиты. Допустимо только в приватных ветках или с последующим push --force.
Хотфикс-ветки как отдельная дисциплина
В Gitflow hotfix/* заводятся прямо от master, ограничивая изменения только баг-фиксом и после ревью сливать их одновременно в master и develop. Это убирает критическую проблему, но не затрагивает незавершённые фичи и не переписывает историю.

Откат артефакта на уровне деплоймента
Артефакт — закрытый, версионируемый результат сборки: Docker-образ, JAR, Helm-release. Его тег (commit SHA, semver или build-номер) хранится в registry и подтягивается пайплайном.
В Kubernetes
kubectl rollout undo deployment/<name>переключает ReplicaSet на предыдущую ревизию, сохраняя историю внутри объекта Deployment.- Для Helm —
helm rollback <release> <revision>; Helm хранит ревизии-чарты вConfigMap, что позволяет мгновенно откатиться.
Когда откат артефакта недостаточен
Если баг вызван изменением схемы БД или Terraform-плана, одного перескока контейнера мало — потребуется откат миграции или инфраструктурного состояния.
GitOps-подход - откат конфигурации
В GitOps-подходе конфиги Kubernetes/Terraform живут в отдельной репе. Условный ArgoCD синхронизирует кластер с HEAD репозитория: достаточно git revert нужного коммита, и контроллер применит прежнюю манифестацию. Такой откат затрагивает только инфраструктуру и не требует перекатывать сам образ.
Плюс существует подход, при котором в конфиг-репозитории можно явно указать, какую версию артефакта надо задеплоить. В таком случае можно выполнить деплой нужной версии, стриггерив пайплайн на изменение в конфиге — он просто возьмёт указанный артефакт и редеплойнет его.
Почему баги просачиваются в master и что с этим делать?

Так что откат — не «план Б», а полноправная часть жизненного цикла доставки.