Рекомендательные системы для аналитиков, часть 1. Постановка задачи
Вы заходите в онлайн-кинотеатр, чтобы скоротать вечер. Вы не знаете, чего хотите, но спустя пару секунд на экране появляется подборка фильмов, и один из них так и манит нажать кнопку "Смотреть". Это работа сложного алгоритма рекомендаций
Есть два варианта того, как рекомендовать пользователю что-либо:
- Предсказать, как пользователь оценит это (конкретное количество "звездочек", которые поставит пользователь)
- Просто отранжировать разные варианты от наилучшего к наихудшему
Вообще, предметная область рекомендательных систем очень интересна и обширна:
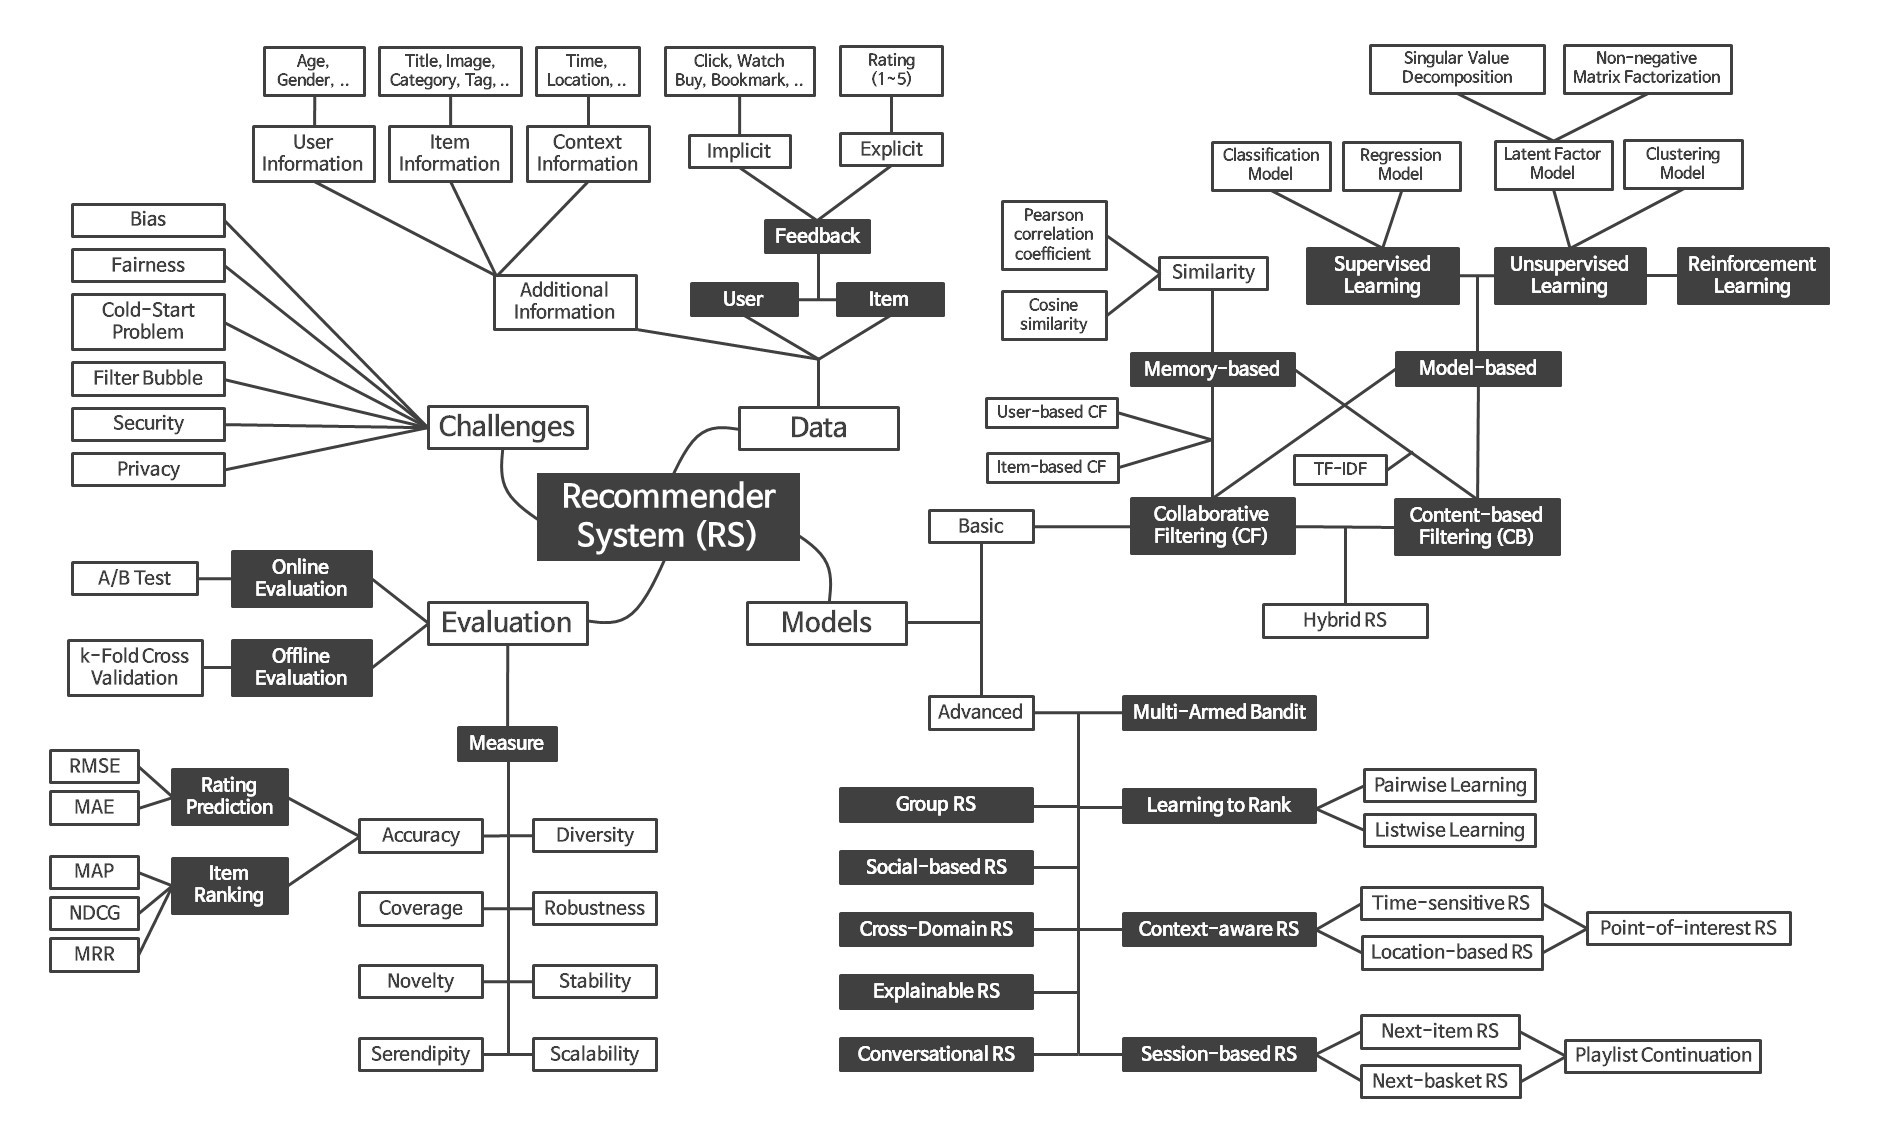
В этой части статьи мы разберем верхнюю часть картинки
Любая рекомендация начинается с данных. Это топливо, на котором работает система. Всю информацию можно разделить на три больших блока:
1. User (Кто ты?)
Система пытается понять своего пользователя. Она фиксирует статичные характеристики (пол, возраст, страна) и то, как вы себя ведете
2. Item (Что это за штука?)
Система должна понимать, что именно она предлагает. Для этого каждый объект (товар, видео, песня) описывается набором признаков:
- Название — ну тут понятно
- Категория — например, Боевики / Комедии
- Теги — короткие метки: юмор, для подростков, про вампиров
- Изображение — визуальная информация, которую нейросети тоже умеют смотреть
3. Context (Где и когда это происходит?)
Представьте, что вам предлагают купить теплые перчатки. Летом, в жару, это будет выглядеть глупо, а в декабре — очень кстати. Контекст — это обстоятельства, которые меняют смысл рекомендации. Это время суток, день недели, ваше местоположение (дом, работа, другой город) и даже устройство, с которого вы зашли (с телефона в метро мы листаем ленту иначе, чем с большого компьютера дома).
Итак, у нас есть данные. Но просто знать, что Иван — 30-летний мужчина из Москвы, а фильм Бойцовский клуб имеет теги драма, психология, экшн — недостаточно. Нужно понять, как Иван относится к Бойцовскому клубу. Это и есть обратная связь (feedback).
Обратная связь бывает двух типов:
- Явная: что вы говорите системе напрямую. Например, оценка по пятибалльной шкале или дизлайк. Но люди часто ленятся оценивать, поэтому такой информации мало
- Неявная: что вы делаете, не задумываясь. Система следит за вашими действиями:
Соединяя данные о пользователе, товаре и контексте с его реакцией, система учится предсказывать предпочтения
Однако не всё так просто, у рекомендательных систем есть куча проблем:
- Информационные пузыри — персонализированая фильтрация информации ведет к замыканию пользователя на логически связанных между собой айтемах. Пользователь не увидит того, что не было в поле его интересов ранее
- Приватность — защита от утечек персональных данных пользователей
- Безопасность — защита от использования слабых мест рекомендательных систем (так называемых атак на модель). Самая популярная и простая атака: накрутка отзывов
- Холодный старт — проблемы с новыми элементами системы:
- Bias (смещение) — возникает, когда алгоритмы отдают предпочтение определённым группам из-за искажений данных. Например, если в базе данных сервиса много данных по деловым брюкам и мало по джинсам, в общем брюки будут более популярны, и система при добавлении новой модели джинс решит, что они никому не нравятся, и будет показывать их в самом низу. До джинс никто не будет долистывать, и система таким образом получает "доказательство", что джинсы никому не нравятся. Замкнутый круг
- Fairness (справедливость) — равное отношение к разным группам пользователей без дискриминации по демографии, полу или другим признакам. Проблема проявляется в демографическом смещении, когда рекомендации хуже для определённых подгрупп (например, по возрасту или нации)
Первое, на что обращают внимание — как именно достигается справедливость. Здесь выделяют два принципиально разных подхода: - Справедливость процесса — это про честность правил игры. Представьте, что система оценивает кандидатов на вакансию. Если алгоритм использует только релевантные признаки (образование, опыт) и игнорирует пол или расу, то сам процесс принятия решения можно считать справедливым. Неважно, кто в итоге получит работу — главное, что ко всем применялись одинаковые критерии.
- Справедливость результата — здесь мы смотрим на финальный расклад. Даже если процесс был идеален, результат может оказаться несправедливым. Например, рекомендательная система в интернет-магазине может показывать дорогие товары только жителям богатых районов, потому что у них выше покупательная способность. С точки зрения процесса всё честно (алгоритм просто максимизирует прибыль), но результат нас не устраивает
В случае, если мы ориентируемся на справедливость результата, мы должны продумать две вещи:
Подробности ответа на эти вопросы — прям техничная техника, поэтому в этой статье не будем их рассматривать. Если вам интересно погрузиться, можн воспользоваться этой схемой:
