Как я собрал evals из своих задач и стал тратить на токены вдвое меньше
Многие компании уже собирают свои evals (наборы задач для проверки агентов) и делают по ним hill climbing: меняют модели и сетапы, дообучают модели, сокращают расход токенов. Другие тем временем используют дорогие фронтирные модели даже на простых задачах. Отдельные разработчики часто делают то же самое.
Поэтому я собрал evals из своих прошлых задач, чтобы найти быстрый и дешёвый способ работать с агентами без потери качества. Уже в первом раунде тестов нашёлся сетап вдвое дешевле. Ниже пошаговый гайд, как собрать свои evals.
Сначала я хотел проверить, сможет ли Pi (легковесный CLI-агент с открытым исходным кодом) решить те же задачи, что и Codex, потратив меньше токенов. Меньший расход токенов может помочь сделать больше в пределах лимитов подписки. На моих задачах Pi потратил меньше токенов. На первом графике: сравнение агентов на GPT-6.1 Sol с настройкой medium: оба решили все задачи, но с Pi средняя цена за задачу почти вдвое ниже ($0.070 против $0.138).
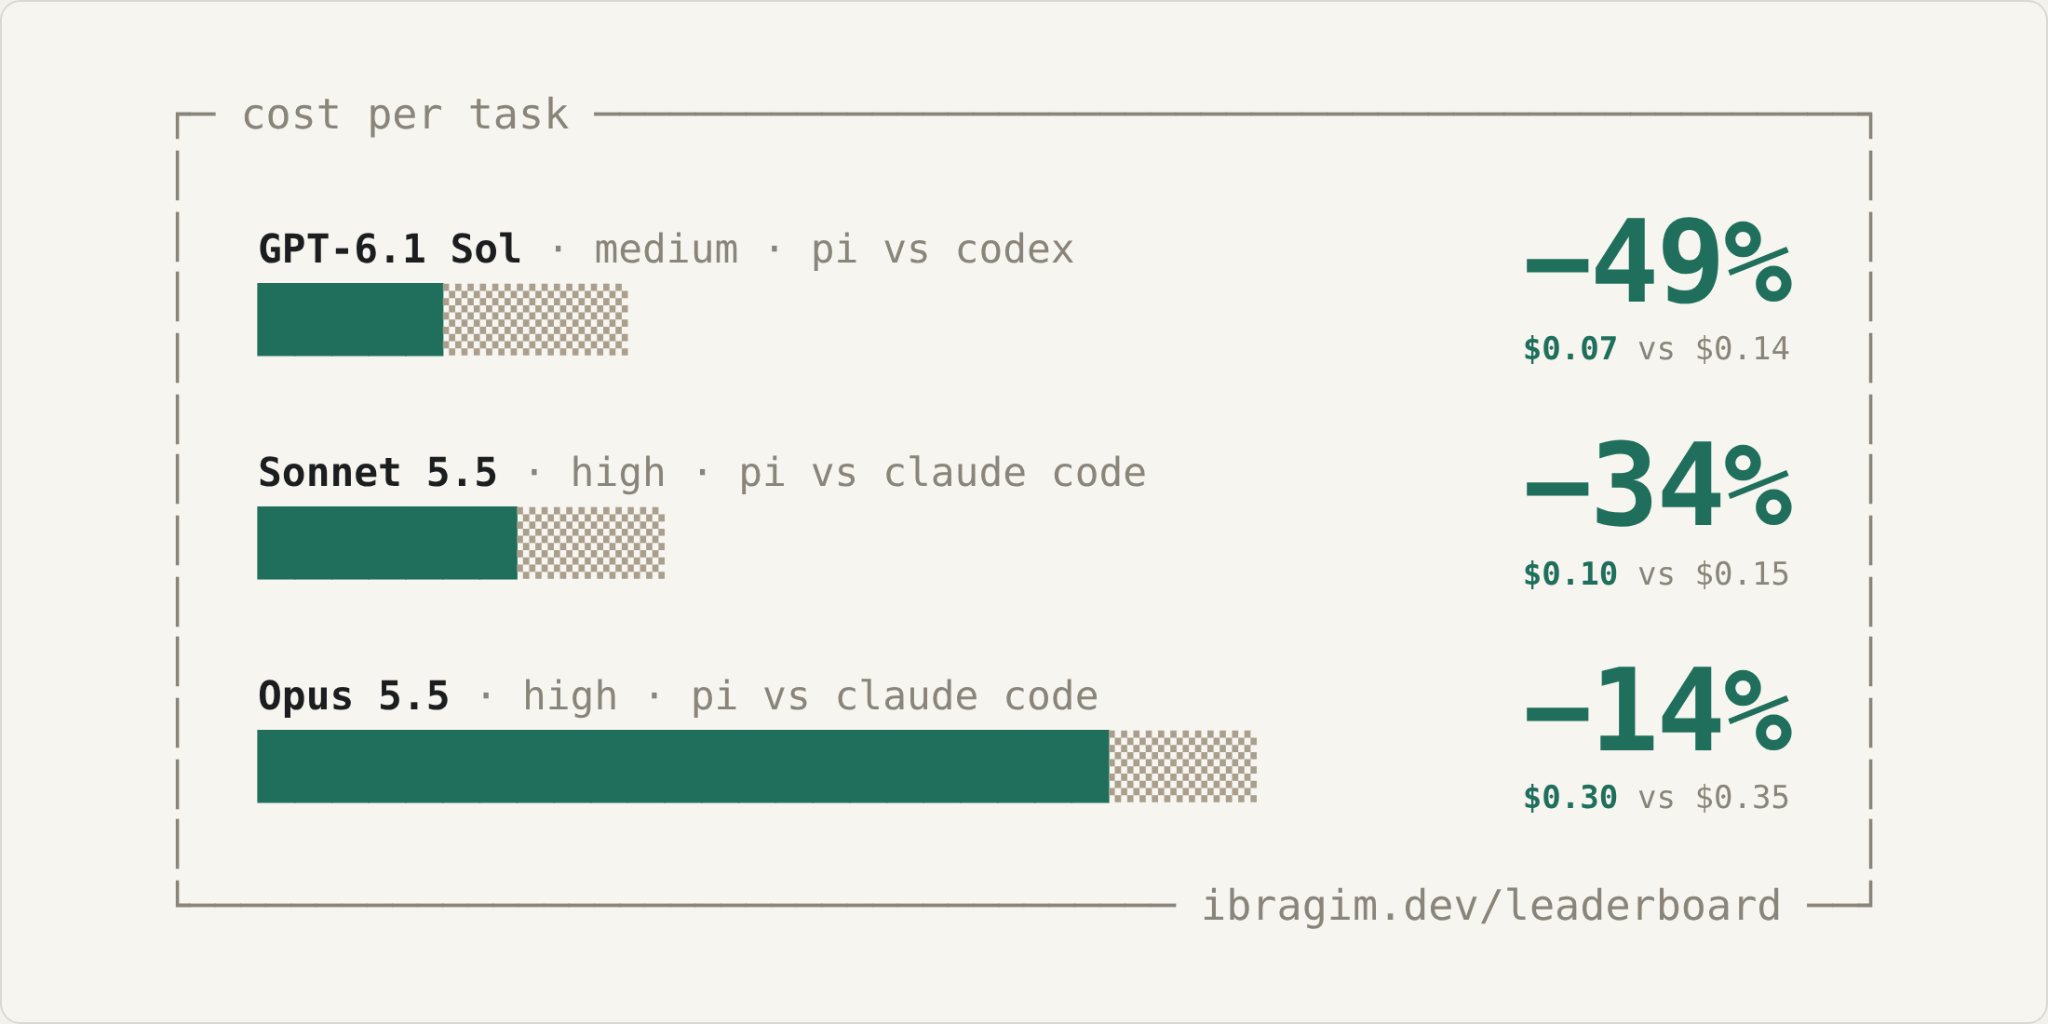
А когда у вас есть свои evals, можно проверять и другие гипотезы. Например, действительно ли инструменты вроде RTK (инструмента для сжатия вывода команд) экономят контекст и окупается ли перевод MCP-серверов в скиллы.
Как собрать свои evals: 6 шагов
- Найти задачи в истории сессий с агентами
- Превратить сессию в задачу и решить, что объяснить агенту, а что он выяснит сам
- Собрать задачу в Harbor (инструменте для запуска и оценки агентов) и закрыть агенту пути к читерству
- Проверить верификатор и отсеять неудачные задачи
- Запустить прогоны и сравнить сетапы по цене и времени
- Разобрать траектории и доработать evals; повторять это после новых прогонов
Я собрал скилл evals-from-sessions, чтобы автоматизировать большую часть этого процесса (подробнее в конце). GitHub
Зачем мне свои evals, если я делаю публичный бенчмарк
Я работаю в Nebius и последние полтора года занимаюсь RL-окружениями и evals для coding-агентов, а ещё поддерживаю публичный лидерборд и большой датасет SWE-rebench (подробнее о проектах на ibragim.dev). SWE-rebench показывает, какая модель сильнее на большом наборе реальных задач из разработки. Но задачи в нём взяты из других проектов. Мне также нужно понимать, какой сетап лучше подходит для моих задач.
С большей частью моей работы современные модели уже справляются. Я хотел найти самый быстрый и дешёвый сетап, который стабильно решает мои задачи. Можно ли для части задач заменить фронтирную модель на что-то быстрое и дешёвое вроде DeepSeek? Помогает ли новый скилл или плагин?
Идея не новая. Сатья Наделла в недавнем интервью говорит, что каждой компании стоит строить свои private evals и делать по ним hill climbing:

Недавно Anthropic выпустили для Claude Code команды build-eval и hillclimb (пост): они помогают собрать evals для приложений, которые вызывают Claude API, и подобрать для них сетап подешевле. В этой статье та же идея, только применённая к самим coding-агентам, с которыми вы работаете каждый день.
Лёгкие сетапы решают мои задачи так же, но быстрее и дешевле

Я проверил каждую конфигурацию на 10 задачах, по три прогона на задачу. Несколько конфигураций решили все задачи во всех трёх прогонах, поэтому я сравниваю их в основном по цене и скорости. Эти результаты помогают выбрать сетап для моей работы, но не говорят, какая модель лучше в целом.
Шаг 1 · Найти задачи в истории сессий
Я экспортировал историю работы с агентами за три месяца, около 1270 сессий. Большинство агентов хранят её локально:
Claude Code: ~/.claude/projects/<project>/<session>.jsonlCodex CLI: ~/.codex/sessions/YYYY/MM/DD/rollout-*.jsonlPi: ~/.pi/agent/sessions/Gemini CLI: ~/.gemini/tmp/<hash>/chats/
Некоторые агенты удаляют старые сессии, так что их лучше скопировать заранее. В транскриптах встречаются API-ключи и другие секреты. Перед тем как отдавать экспорт внешним сервисам или коллегам, я прогоняю его через Gitleaks.
Парсер я не писал. Агент читал историю сессий и собирал в candidates.md таблицу потенциальных задач. Для каждой он записывал:
- что я хотел сделать;
- какие файлы и компоненты затрагивались;
- где агент ошибся и что пришлось исправлять;
- чем всё закончилось;
- можно ли проверить результат автоматически.
Дальше я отбирал кандидатов вручную. Когда контекста не хватало, просил агента показать кусок транскрипта или предложить способ проверки.
Самыми полезными оказались сессии, где агент сначала ошибся, а потом исправлялся по моим замечаниям. Мои замечания часто дают тест-кейсы для верификатора, то есть проверки, которая решает, справился ли агент с задачей.
- Задача похожа на мою обычную работу.
- Можно однозначно проверить, правильно ли она решена.
- Её можно перенести в изолированное окружение с инструментами и данными, которые нужны агенту для решения.
Шаг 2 · Превратить сессию в задачу
Пример: задача compute-provider-cost-with-retry-fallback. На входе записи прогонов агента с повторными попытками, переключениями на другие модели и кэшированием токенов. Нужно посчитать итоговую стоимость нескольких прогонов. Ошибиться можно в нескольких местах: например, неправильно посчитать кэшированные токены или взять цену не той попытки или не той модели.
- Вход: Записи прогонов с повторными попытками, переключениями на другие модели и данными о токенах
- Цель: Правильно посчитать стоимость и вернуть структурированный результат
- Возможная ошибка 1: Посчитать кэшированные токены дважды: и по цене чтения из кэша, и ещё раз как обычные входные
- Возможная ошибка 2: Посчитать стоимость не по той попытке: взять неудачный retry или цену исходной модели вместо той, на которую сработал fallback
- Проверка: Запустить программу на тестовых событиях и сравнить результат. Обе ошибки должен ловить верификатор
Перед сборкой я решаю, что включить в инструкцию, а что агент должен выяснить сам. Спецификацию делю на три части:
- Requirements: какие свойства должно иметь правильное решение.
- Failure modes: какие типичные ошибки должны ловить тесты.
- Must be discovered: что агент должен выяснить самостоятельно по коду или данным.
Здесь в инструкции явно описаны входной формат, правила расчёта, обработка fallback и формат ответа. Готовой реализации и подсказок, где менять код, в ней нет.
Если дать слишком много подсказок, задача становится механической. Если не описать важные требования, верификатор будет проверять то, о чём агенту не сказали.
Шаг 3 · Собрать задачу в Harbor
Задачи я запускаю в Harbor – инструменте для запуска и оценки coding-агентов в изолированных окружениях. Он задаёт общий формат задач для evals и RL-окружений. Каждая задача лежит в своей папке:
my-task/
  instruction.md     # задание для агента
  task.toml          # метаданные и настройки запуска
  environment/
    Dockerfile       # начальное состояние окружения
  tests/
    test.sh          # верификатор: проверяет результат
  solution/
    solve.sh         # эталонное решение
Шаблон создаётся командой harbor task init.
Реальную работу можно перенести двумя способами.
Взять собственный коммит: состояние репозитория до изменения становится окружением, дифф становится эталонным решением. Так сохраняется настоящая структура проекта. Это подходит для приватных evals.
Или написать самостоятельную задачу: оставить требования и ошибки из исходного эпизода, а код, названия и данные заменить. Я использую этот подход, когда код закрытый или я хочу поделиться задачей. Задачу про расчёт стоимости я собрал именно так.
Как закрыть лазейки для reward hacking
Модели умеют читерить, и это нужно пресекать. Если задача из открытого репозитория, агент может найти исправление в интернете или просто в истории Git. Поэтому я заранее закрываю типичные лазейки: например, убираю из sandbox будущие коммиты и эталонный дифф. И, как бы глупо это ни звучало, прошу агента в инструкции не читерить и решать задачу. После прогонов проверяю траектории другим агентом, подробнее об этом в шаге 6.
Шаг 4 · Проверить верификатор и доработать набор
Для своих задач я использую детерминированные проверки: запускаю программу, смотрю содержимое файлов, JSON-вывод и состояние Git. LLM-as-judge не использую. Готовый верификатор проверяю четырьмя способами:
- Oracle: эталонное решение, 5 запусков: Все проходят
- Nop: ничего не делать: Не проходит
- Near-miss: почти правильное решение с одной ошибкой: Не проходит
- Alternative correct: другая корректная реализация: Проходит
Начинал я с 15 задач и сделал 3–5 итераций по всему набору: часть задач доработал, часть выкинул, осталось 10.
Я проверяю верификатор на два типа ошибок:
- Правильное решение не засчитано (false negative). Например, тест ищет конкретную подстроку в сообщении об ошибке, и если модель сформулировала его иначе, решение не засчитывается, хотя оно верное.
- Неправильное решение засчитано (false positive). Обычно потому, что тесты покрывают не каждое требование или проверяют решение не целиком.
Из-за false negatives модели могут упираться в искусственный потолок: например, в 80%, если остальные 20% задач невозможно пройти из-за ошибок проверки. Из-за false positives модели получают баллы за неверные решения. Такие результаты ненадёжны, когда выбираешь сетап подешевле.
Тупик: задача на полтора часа, которая решилась за минуту
Пару месяцев назад я потратил часа полтора, чтобы привести в порядок несколько веток и старых неразрешённых конфликтов в Git. Работая с агентом, я сильно перестраховывался, чтобы ничего не сломать. В sandbox оказалось, что последовательные git merge --ff-only по веткам дают тот же результат. Уже после первых прогонов было видно, что задача слишком лёгкая, и я её выкинул. Теперь я оцениваю сложность задачи по тестовым прогонам.
Шаг 5 · Запустить прогоны
Harbor сам запускает агентов, повторяет попытки и собирает логи. У Harbor есть и свои скиллы для агентов. Пример команды:
harbor run -p tasks/ -a pi -m <model> \
  --ak thinking=medium -k 3 -n 5
Для каждой конфигурации я смотрю результат каждой попытки, долю задач, решённых во всех трёх попытках, цену, время, число шагов и токенов.
Я проверяю логи на инфраструктурные ошибки, таймауты и проблемы с сетью и учитываю такие сбои отдельно от ошибок модели.
Шаг 6 · Разобрать траектории и доработать evals
После прогонов агент читает траектории (пошаговые записи того, что делали модели) и помогает найти лазейки и ошибки верификатора: где он отклонил правильное решение или засчитал неверное. Я проверяю его выводы, обновляю задачи и чиню верификатор.
После каждой новой серии прогонов я повторяю проверки из шага 4 и исправляю найденные проблемы, прежде чем сравнивать сетапы.
Скилл для сборки своих evals
Я сделал скилл evals-from-sessions, который автоматизирует эти шаги: извлекает задачи из сессий, готовит спецификации, собирает окружения Harbor и пишет верификатор. Сам я подключаюсь дважды: утверждаю задачу и требования до сборки и проверяю готовую задачу перед включением в набор. Можно также просто дать эту статью своему агенту как инструкцию.
Скилл на GitHub: github.com/ibragim-bad/evals-from-sessions
npx skills add ibragim-bad/evals-from-sessions
Также можно установить как плагин Claude Code / Codex или через Pi:
pi install git:github.com/ibragim-bad/evals-from-sessions
Теперь я использую эти evals, чтобы сравнивать модели, агентов и инструменты на своих задачах. Самый дорогой сетап оказался не лучшим выбором для моей работы.
Подписывайтесь @c0mmit, чтобы не пропустить следующие тексты, и пишите вопросы в комментариях или в личку: как собрать свои evals, с чего начать, как устроены RL-окружения.