Как я собрал evals из своих задач и стал тратить на токены вдвое меньше
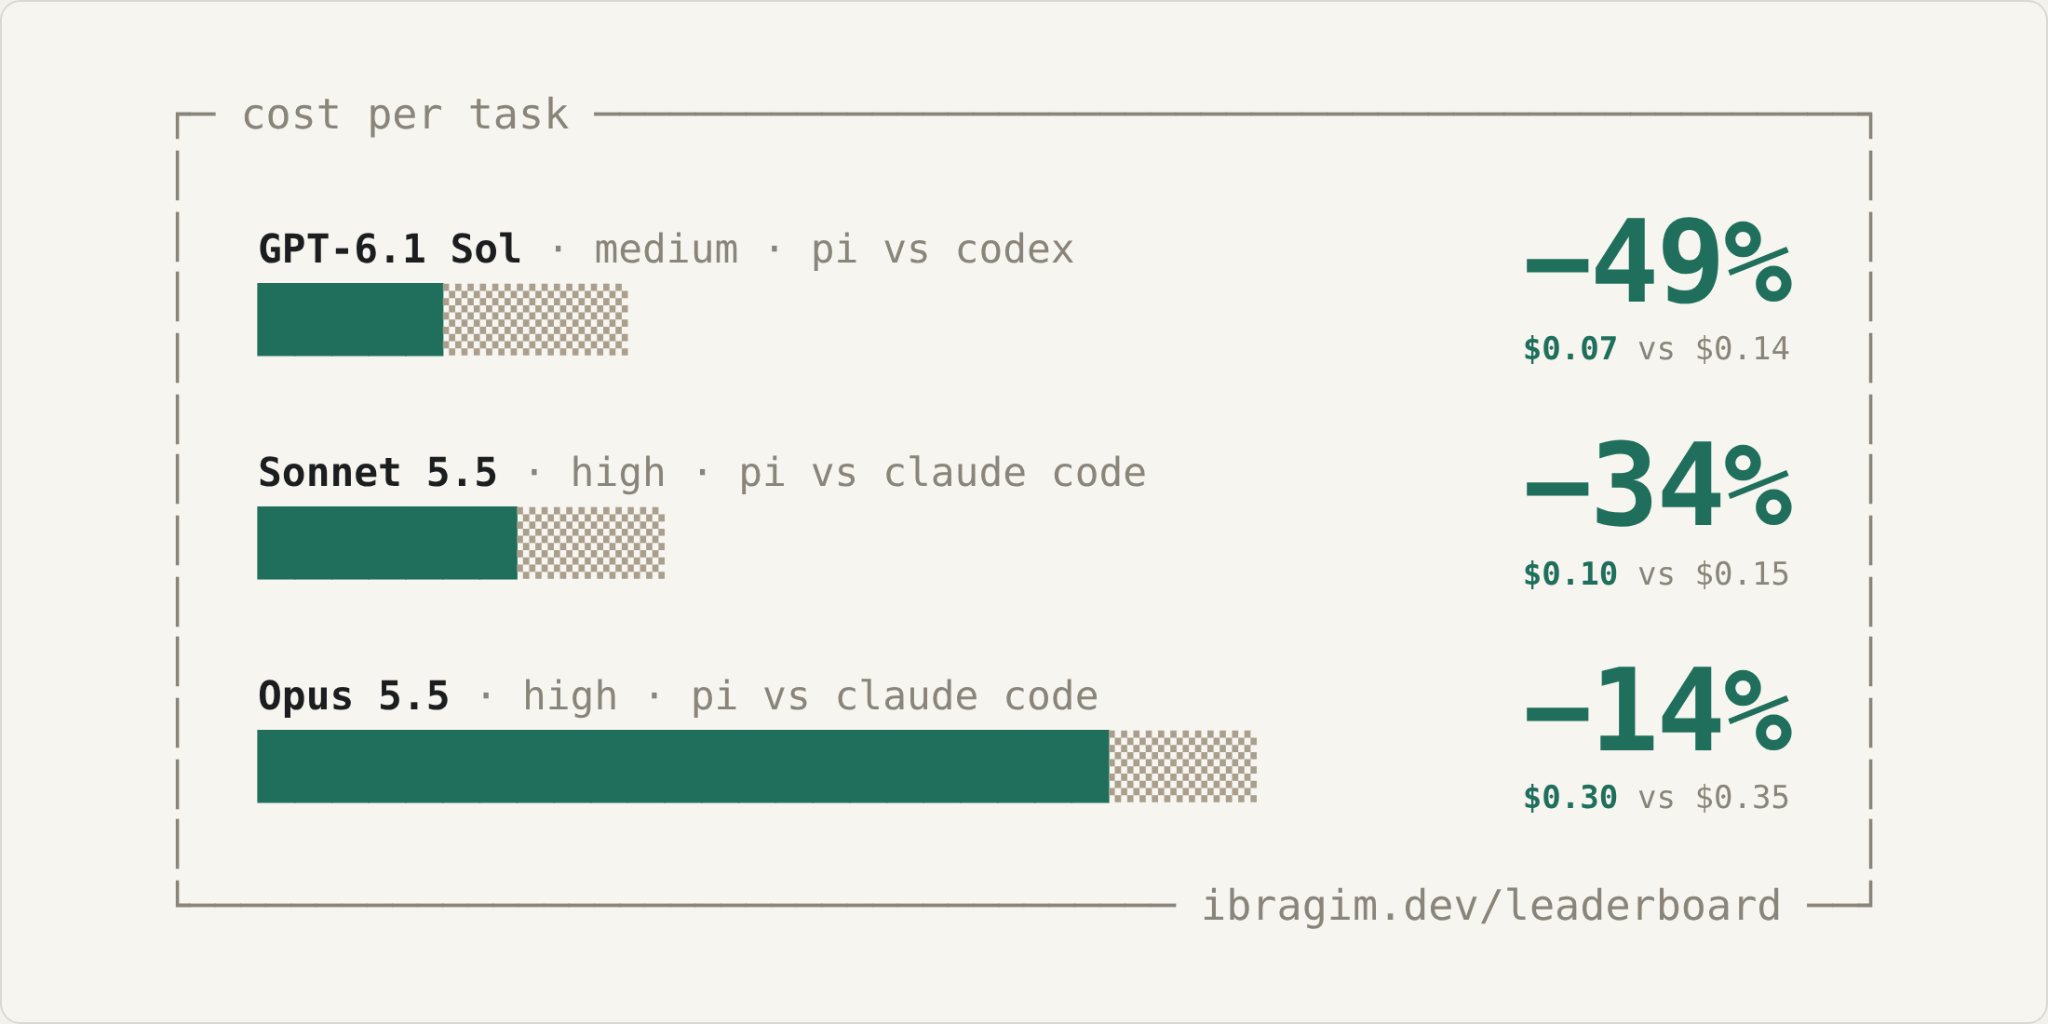
Многие компании уже собирают свои evals (наборы задач для проверки агентов) и делают по ним hill climbing: меняют модели и сетапы, дообучают модели, сокращают расход токенов. Другие тем временем используют дорогие фронтирные модели даже на простых задачах. Отдельные разработчики часто делают то же самое.
2.6K
SWE-rebench Leaderboard: большое мультиязычное обновление

В свежем релизе SWE-rebench мы собрали 111 задач на пяти популярных языках программирования, ужесточили фильтрацию и добавили аналитику на базе траекторий агентов. Лидеры: Fable 5, Grok 4.5, Opus 5, GLM-5.2 и GPT‑5.6 Sol. При этом GPT‑5.6 Sol резко выделяется эффективностью траекторий: модель показывает высокое качество при существенно меньшем числе действий.
322