Галлюцинации нейросетей в цифрах — не баг, а архитектурная ошибка. Как мы её исправили
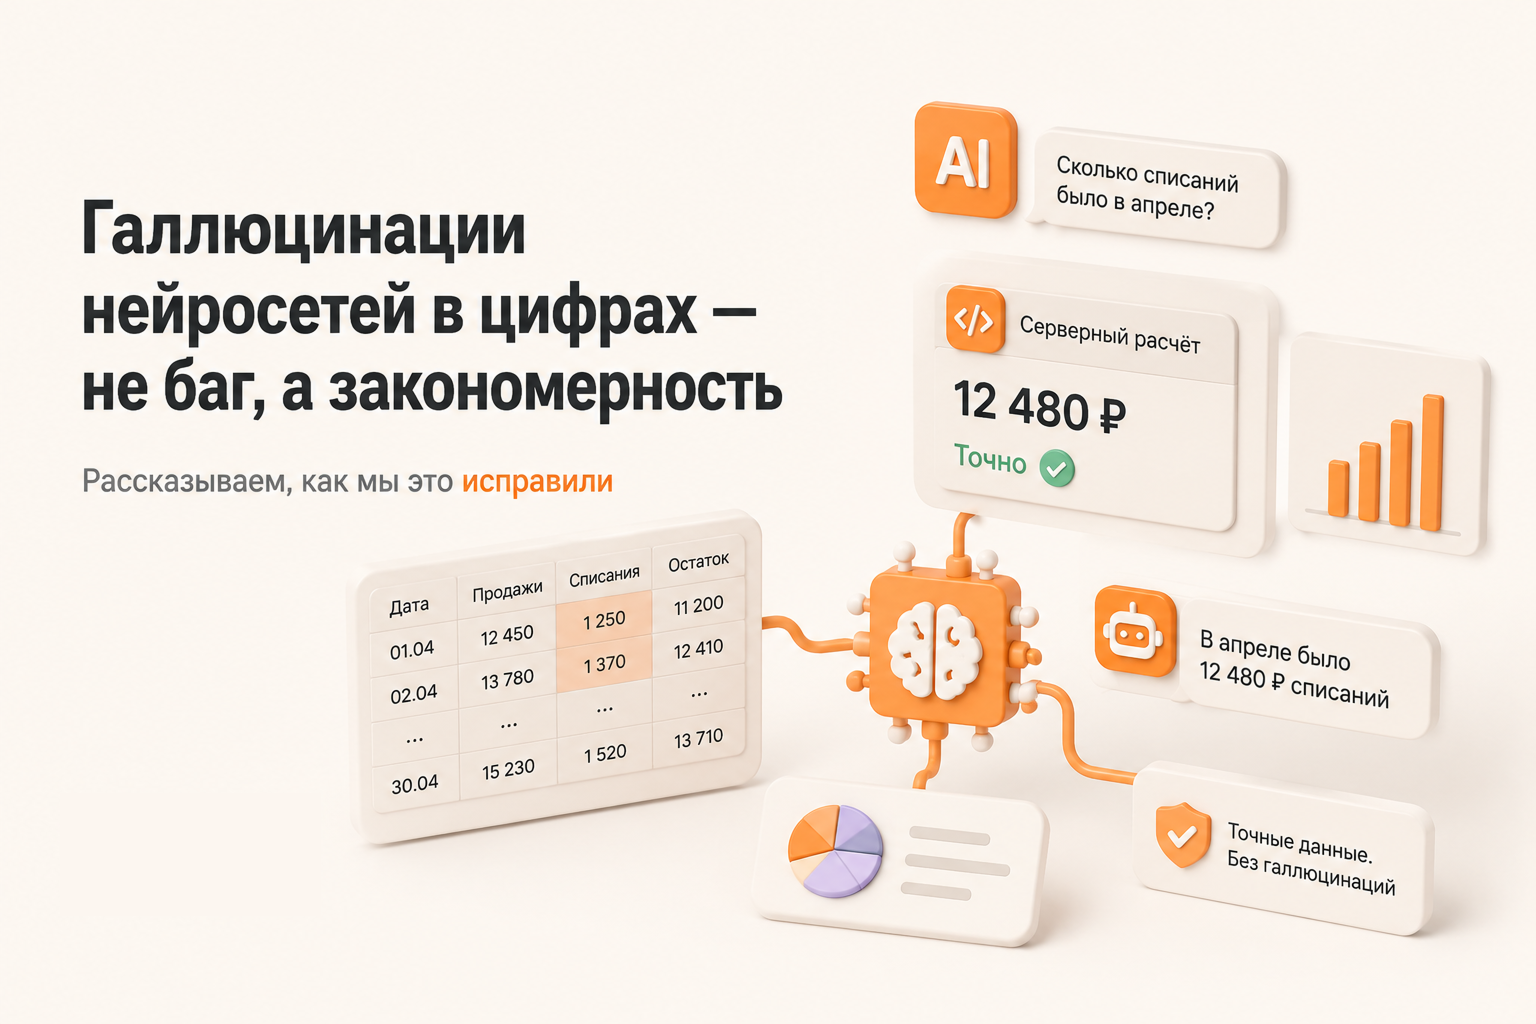
Практически каждая компания, пытавшаяся скормить ИИ отчёт в Excel и задать вопрос «какие продажи в регионе?», однажды обнаружила: ответ красив, но цифры вымышлены. Это не сбой конкретной модели, а закономерность, заложенная в самой природе языковых моделей.
LLM — не калькулятор и не база данных. Она не выполняет арифметические операции над ячейками, а предсказывает наиболее вероятную последовательность токенов. Когда вы отправляете таблицу на десятки тысяч строк, середина документа «проваливается» — внимание модели распределено неравномерно. Модель не может сказать «я не знаю» и заполняет пробелы правдоподобной, но фиктивной информацией. Производители заявляют контекстное окно в 200 тысяч токенов, но деградация начинается уже на первой трети. Ответ остаётся таким же уверенным, и без построчной сверки отличить правду от вымысла невозможно. А если сверять каждую цифру вручную, то зачем ИИ?
Почему инжиниринг промптов не спасает
Первое, что делают команды, — улучшают инструкции: «перепроверь расчёты», «опирайся только на таблицу». Это даёт косметический эффект, но природа ошибок не меняется: модель всё ещё пытается «считать». Более того, улучшенные промпты повышают опасность — ложные цифры упаковываются в ещё более убедительный текст, и бизнес начинает принимать решения на основе данных, которые выглядят корректными, но таковыми не являются. Лечить галлюцинации промптами — всё равно что красить стены в доме с треснувшим фундаментом.
Архитектурное решение: модель не видит сырые данные
Единственный работающий принцип: цифры считает строгий серверный код, а нейросеть лишь оформляет готовые результаты.
Мы переопределяем роль ИИ: из «аналитика» он превращается в интерфейс. Система работает так:
- Таблица загружается в оперативную память сервера и не покидает контур заказчика.
- Под каждую аналитическую задачу создаётся жёсткий детерминированный алгоритм с чёткими входными параметрами.
- Нейросеть получает не данные, а описание доступных инструментов — какие функции можно вызывать и с какими параметрами.
- Получив запрос, модель выбирает нужную функцию, вызывает её и получает точный результат. Её задача — сформулировать ответ на естественном языке.
Галлюцинациям в цифрах в такой архитектуре неоткуда взяться: модель не выполняет расчёты, значит, не может в них ошибиться.
Кейс: Рестофотоаналитика
Команда АЙТИФОКС применила подход для сети корпоративного питания, управляющей десятками точек в отелях. Заказчик хотел заменить ручного аналитика, часами сводившего отчёты по списаниям и остаткам.
Первая гипотеза — загрузить таблицу напрямую в нейросеть — провалилась: модель врала в цифрах, придумывала несуществующие блюда, путала столбцы. Цена ошибки, помноженная на масштаб сети, — прямые убытки.
После перехода к архитектуре «сервер считает — модель формулирует»:
- Ошибки в цифрах исключены полностью.
- Стоимость запроса снижена в 3–20 раз (с 30–100 тыс. токенов до 1,5–3 тыс.).
- Прототип создан за три недели силами двух разработчиков.
- Анализ ускорился на 95%: минуты вместо часов.
Дополнительный инсайт: для табличной аналитики разницы между старшей и облегчённой версиями нейросети нет. Протестировали — не переплатили за избыточную мощность.
Выводы для бизнеса
- Откажитесь от схемы «загрузил и спросил». Это архитектурный тупик.
- Разделите расчёты и оформление: код считает, нейросеть формулирует.
- Не переплачивайте за флагманские модели без тестов — берите минимально достаточную версию.
- Оставьте человека на финальной проверке: это зрелый риск-менеджмент, а не слабость системы.
Принцип универсален для розницы, логистики, финансов, производства — везде, где решения принимаются на основе табличных данных. Если ваши нейросети всё ещё врут в отчётах — проблема в архитектуре, а не в ИИ.
Обсудить применение подхода к вашим задачам → https://itfox-web.ru/ru/cases#consultation